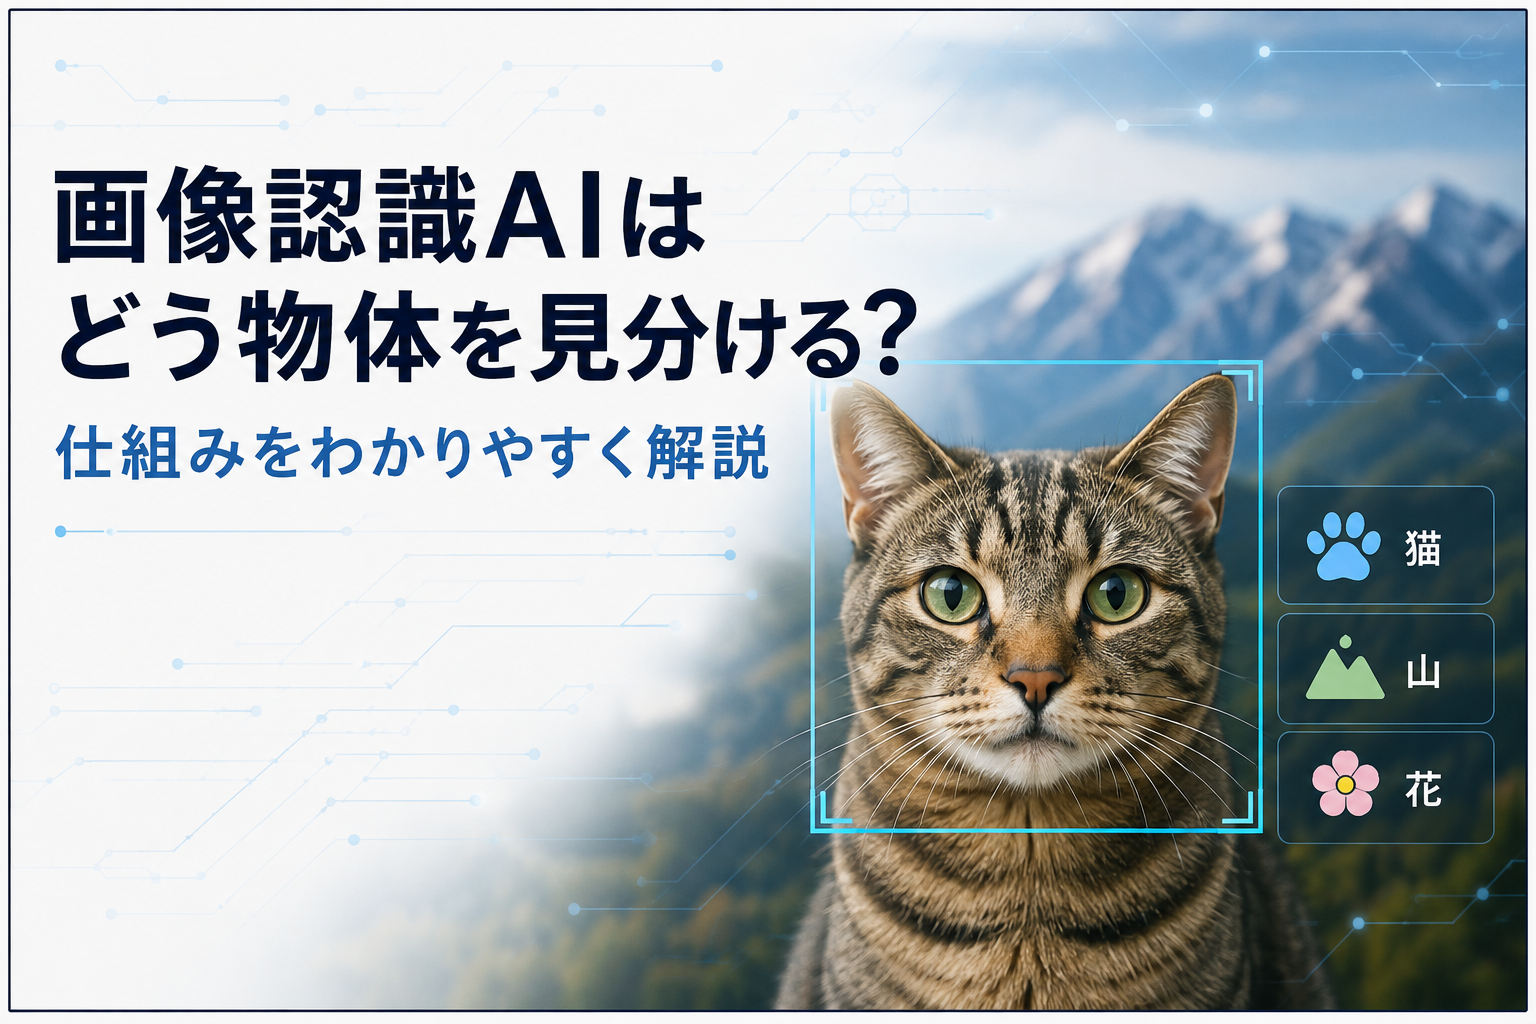
画像認識AIの仕組みは、画像を数値の配列として受け取り、学習で調整した計算を通して物体の種類や位置を推定します。「猫の耳があるから猫」と人間が一つずつ規則を書く方法とは異なり、ニューラルネットワークでは多数の重みをデータから調整します。ただし、判断に使った特徴が人間の考える「耳」や「顔」と一致するとは限りません。
ここでは教師あり学習のCNN(畳み込みニューラルネットワーク)による画像分類を例に、数値がどう変わるかを追います。数値例は仕組みを説明するために本記事で作成したもので、学習済みモデルの実測値ではありません。
画像認識AIの仕組みを知る前に:分類・検出・領域分割の違い
| 課題 | 入力が猫と犬の写真なら | 出力の例 |
|---|---|---|
| 画像分類 | 画像全体の種類を判定する | 「猫」などのクラス。複数ラベルを付ける設計もある |
| 物体検出 | 猫と犬をそれぞれ見つける | クラスと、それぞれを囲む矩形の座標 |
| セグメンテーション | 画素ごとに領域を分ける | 猫・犬・背景などの画素ラベル |
一つの画像に猫と犬がいる場合、一つのクラスしか出せない分類器では「両方の位置を知りたい」という目的を満たせません。モデル選びの前に必要な出力を決めることが大切です。
画像はどう数値になる?
縦100×横100画素のRGB画像なら、赤・緑・青の3成分があるため、100×100×3=30,000個の値で表せます。一般的な8ビット画像では各成分が0〜255で、学習時には255で割るなど、モデルに合わせた前処理を行います。配列の並びは実装によって異なり、PyTorchのConv2dでは通常、バッチ数・チャンネル数・高さ・幅の順です。PyTorch公式:Conv2d。
例えば1画素のRGB値が(255, 128, 0)なら、255で割った値は約(1.000, 0.502, 0.000)です。これは色の数値表現を変えた段階で、まだ猫だと判断したわけではありません。学習済みモデルを使うときは、画像サイズや平均・標準偏差による正規化も、そのモデルが指定する前処理に合わせます。
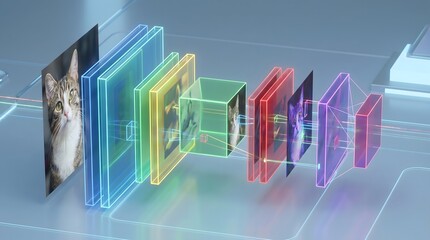
数値を並べただけでは、猫と背景の区別はまだありません。CNNは近くの画素をまとめて計算し、その結果を次の層へ渡します。
CNNの畳み込み:3×3のフィルターを手計算する
説明を簡単にするため、グレースケール画像の小さな領域を考えます。次の表の各行を上から重ねると、3×3の画像片XとフィルターKになります。右側だけ明るい画像片です。
| 行 | 画像片Xの3画素 | フィルターKの3係数 |
|---|---|---|
| 上 | 0, 0, 1 | −1, 0, 1 |
| 中 | 0, 0, 1 | −1, 0, 1 |
| 下 | 0, 0, 1 | −1, 0, 1 |
同じ位置の数を掛けて全部足すと、1行あたり0×(−1)+0×0+1×1=1、3行で出力は3です。画像片が全部1なら、各行が−1+0+1=0となり、出力は0です。このフィルターは一様な明るさよりも左右の差に反応します。バイアスはここでは0としました。
フィルターを画像上でずらしながらこの計算をすると、場所ごとの反応を並べた「特徴マップ」ができます。CNNで畳み込みと呼ばれる処理は、PyTorchではフィルターを反転しない相互相関として実装されています。上の計算もその定義です。
実際には複数のチャンネル・フィルターを使い、係数を学習します。この手作りフィルターが、学習後に必ず現れるわけではありません。層を重ねると広い範囲の情報を組み合わせられますが、各層が必ず「線→耳→猫」という人間に分かる役割分担になるわけでもありません。
ReLU(レルー)はmax(0, x)、つまり負の値を0にし、正の値をそのまま通す変換です。例えば[−3, 0, 3]は[0, 0, 3]になります。こうした非線形変換を間に入れることで、線形計算だけでは表せない関係を扱えます。プーリングで空間サイズを小さくする構成もありますが、物体の移動や回転に常に不変になる保証はありません。
「学習する」とは、どの数字を変えること?
分類器が猫・犬の2種類についてスコアを出し、softmaxで猫0.8、犬0.2という値に変換したとします。正解が猫のとき、重み付けやラベル平滑化を使わない交差エントロピー損失はL=−ln(0.8)≈0.223です。猫を0.2としか予測できなければL≈1.609となり、より大きな損失になります。PyTorch公式:CrossEntropyLoss。
この損失が小さくなる方向を調べるのが勾配計算です。勾配が正なら、その重みを少し増やすと損失が増える方向を表します。例えば、ある重みw=0.50で、損失の微分∂L/∂w=0.30、学習率η=0.10だったなら、単純な勾配降下法の1回の更新は次のようになります。
wの新しい値 = w − η×∂L/∂w
= 0.50 − 0.10×0.30 = 0.47
学習率が大きすぎると損失が増えることもあるため、更新のたびに改善する保証はありません。これは一つの重みに注目した別の数値例で、前の確率0.8から微分0.30を求めたわけではありません。誤差逆伝播は各重みの勾配を計算し、オプティマイザーがその勾配を使って重みを更新します。両者は区別できます。PyTorch公式:ニューラルネットワークの学習手順。
学習が済んだモデルで新しい画像を判定する「推論」では、通常は重みを固定して出力を計算します。また、猫0.8という値はモデルの出力であって、そのまま現実の正解率80%を保証するものではありません。
正解率だけでは、苦手な画像が見えない
猫40枚、犬60枚の未学習画像を評価したとします。次の表は説明用の仮想結果です。
| 実際の種類 | 猫と予測 | 犬と予測 |
|---|---|---|
| 猫40枚 | 30枚 | 10枚 |
| 犬60枚 | 5枚 | 55枚 |
正解率は(30+55)/100=85%。一方、猫と予測した35枚のうち本当に猫だった割合(猫の適合率)は30/35≈85.7%、実際の猫40枚のうち見つけた割合(猫の再現率)は30/40=75%です。「猫を見逃さない」目的なら、全体の正解率だけでなく10枚の見逃しに注目する必要があります。
さらに、室内の猫だけで学習していたら、屋外の猫を見逃すかもしれません。背景・撮影機器・明るさ・遮蔽の有無ごとに結果を分けると、失敗の原因を調べやすくなります。データを増やす場合も、似た写真の枚数だけを増やすより、不足している条件を補う方針が必要です。
自分で試すときのデータの分け方
重みを調整する訓練用、設定を選ぶ検証用、最後の性能を測るテスト用を分けます。同じ写真の切り抜きや同じ連写が訓練側とテスト側に入ると、新しい場面への強さを過大評価するおそれがあります。例えば撮影日や個体単位で分け、画像の水増しは分割後に訓練用へ適用します。
テスト結果を見て何度も設定を選ぶと、そのテストにも合わせ込んでしまいます。試行の比較は検証用で行い、最後のテストは評価のために残す、という役割分担にします。これは上の仮想結果を実際に測るときにも必要な条件です。
画像認識はCNNだけではない
画像を小さなパッチに分けてTransformerへ入力するVision Transformer(ViT)もあります。CNNは仕組みを学ぶ有用な出発点ですが、画像認識全体と同義ではありません。どの方式が適するかは、データ・計算量・求める出力によります。Dosovitskiyほか「An Image is Worth 16×16 Words」(原著論文)。
重み・活性化関数・層の関係をもう少し数式で知りたい方は、ニューラルネットワークの仕組みへ進めます。まずは上の3×3の画像片を左右反転し、出力が3から−3へ変わることを計算してみると、フィルターが何に反応したかを確かめられます。
使う場面によって、許せる誤りが変わる
写真整理なら誤ったタグを後で直せますが、工場の検品では不良品の見逃しと良品の誤廃棄で損失が異なります。モデルの名前や正解率だけで選ばず、どの誤りを減らしたいか、人がどこで確認するかを決めます。医療画像の結果も診断そのものと同一視せず、想定する患者群や撮影条件での検証が必要です。
コメント