
ニューラルネットワークとは?
ニューラルネットワーク(Neural Network)は、神経回路から着想を得た、数値変換を組み合わせる機械学習の手法であり、ディープラーニング(深層学習)の基盤技術として広く活用されています。画像認識、自然言語処理、自動運転、生成AIなど、現代の多様な分野で革新的な成果を上げています。ニューラルネットワークは、データを入力として受け取り、複雑なパターンを学習し、予測や分類を行う能力を持ちます。この記事では、ニューラルネットワークの基本構造、数学的基礎、種類、応用例、歴史、最新の研究動向、課題、倫理的・社会的影響を詳細に解説し、その技術の魅力と可能性を探ります。
ニューラルネットワークの基本構造
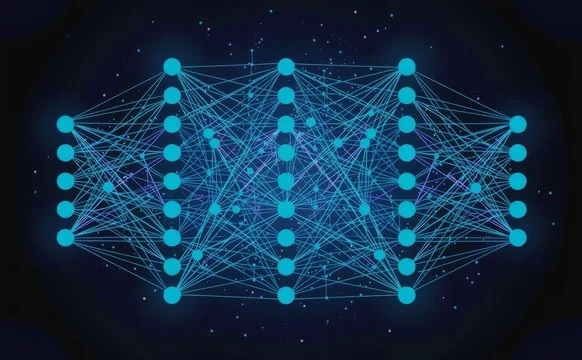
ニューラルネットワークは、以下の3つの主要な層で構成されます:
- 入力層(Input Layer):外部からデータを受け取る層。たとえば、画像認識ではピクセルの輝度値(0~255)が入力されます。
- 中間層(Hidden Layer):入力データを重みとバイアスを用いて変換し、特徴を抽出する層。ディープラーニングでは複数の中間層が積み重ねられ、複雑なパターンを学習します。
- 出力層(Output Layer):最終的な予測結果を出力する層。たとえば、画像分類タスクでは「犬:0.9、猫:0.1」のような確率分布を生成します。
各層はニューロン(ノード)と呼ばれる単位で構成され、ニューロン間は重み付きの接続で結ばれます。層の数やニューロンの数が増えるほど、モデルの表現力が高まります。たとえば、単純なモデルでは中間層が1~2層であるのに対し、深いネットワーク(例:ResNet)では数十~数百層が使用されます。

ニューラルネットワークの数式:ニューロンの出力
各ニューロンの出力は、入力データに重みとバイアスを適用し、活性化関数を通じて処理することで計算されます。このプロセスは以下の数式で表されます:
:ニューロンの出力
:入力値(例:ピクセルの輝度値)
:各入力に対応する重み(学習により調整)
:バイアス(調整値)
活性化関数
例として、入力、重み、バイアスの場合、計算は以下のようになります:
この結果は活性化関数 ( f ) によって変換され、次の層に渡されます。ここまでは順伝播であり、重みは変化していません。学習には、この出力から損失を計算し、勾配に基づいて重みを更新する工程が必要です。同じ入力でも、シグモイドなら出力0.5、ReLUなら0となります。
活性化関数の役割と種類
活性化関数は、ニューロンの出力を変換し、非線形性を導入することでモデルの表現力を高めます。以下は代表的な活性化関数の種類と特徴です:
ステップ関数
ステップ関数は、入力が閾値以上なら1、未満なら0を出力します。閾値では微分できず、それ以外では微分が0です。そのため、通常の勾配に基づく学習には適しません。
シグモイド関数
シグモイド関数は出力を0~1の範囲に収め、確率的な解釈が可能なため、分類問題の出力層でよく使用されます。例:
の場合、
しかし、勾配消失問題(深い層での学習が停滞する)が発生しやすい欠点があります。
ReLU(Rectified Linear Unit)
ReLUは負の入力を0にし、正の入力をそのまま出力します。計算が高速で、勾配消失問題を軽減するため、多くのニューラルネットワークで使われます。ただし、負の入力で勾配が0になるため、一部のニューロンが「死ぬ」(学習に参加しない)問題があります。
その他の活性化関数
Leaky ReLU:負の入力に対して小さな勾配(例:0.01x)を許す改良版。
Tanh:出力は−1より大きく1より小さい範囲。原点での傾きは1ですが、絶対値の大きい入力では傾きが小さくなります。
Swish:Googleが提案した関数で、
滑らかな関数ですが、ReLUより高性能になるかはモデルと課題によります。

誤差関数(損失関数)と学習目標
ニューラルネットワークは、予測値と正解値の差を最小化するように学習します。この差を定量化するのが誤差関数(損失関数)です。代表的な損失関数として、平均二乗誤差(MSE)があります:
:誤差(損失)
:データ数
:正解ラベル(例:猫なら1、犬なら0)
:予測値
例:2つのデータで、
、
の場合、
分類問題ではクロスエントロピー損失がよく使われます。次の式は正解が0か1の二値分類で、N件の損失を合計したものです。平均にする場合はNで割ります。多クラス分類には別の形を使います:
損失関数は、モデルがどれだけ正しい予測から外れているかを示し、学習の目標はこれを最小化することです。
勾配降下法(Gradient Descent)
ニューラルネットワークは、損失関数を最小化するために勾配降下法を用いて重み
とバイアス
を更新します。更新式は以下の通りです:
:更新後の重み
:現在の重み
:学習率(例:0.01)
:損失の重みに関する偏微分(勾配)
学習率
は更新のステップサイズを決定します。大きすぎると学習が不安定になり、小さすぎると収束が遅くなります。実際には、確率的勾配降下法(SGD)やその改良版(例:Adam最適化)が使用されます。Adamは勾配の移動平均と二乗の移動平均を使い、パラメータごとの更新幅を調整します。
Adamでは初期値の偏りも補正する
時刻tの勾配をgtとし、m0=v0=0から始めます。次は重み1個についての基本形です。
mt=β1mt−1+(1−β1)gt
vt=β2vt−1+(1−β2)gt²
m̂t=mt/(1−β1t)、v̂t=vt/(1−β2t)
wt=wt−1−ηm̂t/(√v̂t+ε)
βは平均の残し方、ηは学習率、εは分母の数値安定化に使う小さい正数です。0から始めた平均が初期に小さく見積もられるため、帽子記号の値へ補正してから更新します。詳しくはKingma・Baの原著論文およびPyTorch公式の更新式を参照してください。

ニューラルネットワークの種類
ニューラルネットワークには、用途に応じた多様な種類があります:
- 全結合ニューラルネットワーク(FCNN):隣り合う層を全結合する構造。入力d個、出力h個ならバイアス込みでdh+h個のパラメータを持ちます。
- 畳み込みニューラルネットワーク(CNN):近傍の構造と重みの共有を利用。画像のほか時系列にも使え、プーリングを使わない構成もあります。例:AlexNet、ResNet。
- 回帰型ニューラルネットワーク(RNN):時系列データや自然言語処理に適し、過去の情報を記憶。LSTMやGRUが改良版として人気。
- トランスフォーマー:自己注意機構(Self-Attention)を用いて長期依存関係を効率的に学習。例:BERT、GPT。
- 生成的敵対ネットワーク(GAN):生成器と識別器が競合し、リアルなデータ(例:画像、音声)を生成。画像生成の手法の一つであり、画像生成AIすべてがGANではありません。
- グラフニューラルネットワーク(GNN):グラフ構造のデータを扱い、ソーシャルネットワークや分子解析に使用。
応用例
ニューラルネットワークは多様な分野で活用されています:
- 画像認識:顔認識、医療画像診断(例:X線画像からの腫瘍検出)。検証対象の患者群、見逃し率、誤検出率を確認しないと臨床での有用性は判断できません。
- 自然言語処理:翻訳(Google Translate)、チャットボット、音声認識(Siri、Alexa)。
- 自動運転:物体検出、経路計画、交通予測。例:TeslaのAutopilot。
- 生成AI:画像生成(DALL·E)、文章生成(GPT)、音楽生成。
- 金融:株価予測、詐欺検知。例:異常取引のリアルタイム検出。
- 医療:薬剤発見、遺伝子解析、診断支援。例:AlphaFoldによるタンパク質構造予測。
- ゲーム:AIエージェント(AlphaGo)、リアルタイム戦略最適化。
歴史の概略
ニューラルネットワークの歴史は以下のマイルストーンで進化しました:
- 1943年:マカロックとピッツがニューロンの数学モデルを提案。
- 1958年:フランク・ローゼンブラットがパーセプトロンを開発。単層ニューラルネットワークの基礎。
- 1986年:誤差逆伝播法(Backpropagation)が普及し、多層ネットワークの学習が可能に。
- 2012年:AlexNetがImageNetコンテストで圧勝し、ディープラーニングブームが始まる。
- 2017年:トランスフォーマーが登場し、自然言語処理が飛躍的に進化。
- 2020年代:GPT-3、DALL·E、Llamaなど大規模モデルが主流に。
1回の学習を手計算する
最初の例をシグモイド出力の二値分類器とし、正解を1とします。z=Σwixi+b=0なので、予測p=0.5、1件の損失L=−ln(p)≒0.693です。ここでは自然対数を使います。
シグモイドと二値クロスエントロピーを組み合わせると、連鎖律から∂L/∂z=p−1=−0.5。したがって重みの勾配は(−0.25, −0.40, −0.10)、バイアスの勾配は−0.5です。学習率0.1の単純な勾配降下法で更新すると、次のようになります。
| パラメータ | 更新前 | 更新後 |
|---|---|---|
| w₁ | 0.2 | 0.225 |
| w₂ | −0.5 | −0.46 |
| w₃ | 1.0 | 1.01 |
| b | 0.1 | 0.15 |
同じ入力で再計算するとz=0.0965、p≒0.5241、L≒0.6461となり、この1件については損失が減りました。これは計算を追うための例で、1件への適合が未知の入力に対する正確さを保証するわけではありません。
多層の場合も考え方は同じで、誤差逆伝播は連鎖律を使い各重みの勾配を効率よく計算します。逆伝播が勾配を計算し、SGDやAdamがその値を使って更新する、と役割を分けると理解しやすくなります。Googleの学習解説でも、この二つの工程を確認できます。
課題と展望
ニューラルネットワークには以下のような課題があります:
- 計算コスト:大規模モデルの訓練には膨大な計算リソース(GPU/TPU)と電力が必要。費用はデータ量、精度、機器、試行回数にも左右されます。
- 過学習:訓練データに過適合し、汎化性能が低下。
- データ依存性:高品質なデータが必要。偏ったデータはバイアスを増幅。
- 説明可能性:ブラックボックス問題により、予測の根拠が不明瞭。
- 倫理的問題:ディープフェイク、誤情報、プライバシー侵害。
今後の展望としては、以下が期待されます:
- 省エネルギー技術:量子コンピューティングやエッジAIの進展。
- 汎用人工知能(AGI):単一タスクを超え、汎用的な知能を目指す。
- 倫理的・法的枠組み:AIガバナンスの構築。
倫理的・社会的影響
ニューラルネットワークの普及は社会に大きな影響を与えています。医療診断の精度向上や労働効率化はポジティブな面ですが、以下のような懸念も存在します:
- 雇用への影響:自動化による仕事の喪失(例:製造業、運輸業)。
- プライバシー:顔認識やデータ収集による監視社会のリスク。
- 偏見と公平性:訓練データの偏りによる差別的な出力。
- ディープフェイク:偽動画や音声の悪用。
例えば顔認識なら、全体の正解率だけでなく、利用者の属性や撮影条件ごとの誤りを調べます。データを使う権限、保管期間、誤判定時に人が訂正する方法も、モデルの数式とは別に設計する必要があります。

まとめ
ニューラルネットワークは、重み・バイアス・活性化関数を用いて複雑なパターンを学習し、画像認識から生成AIまで幅広い応用を実現しています。パーセプトロンからトランスフォーマーへと進化し、2020年代には大規模モデルが主流となりました。しかし、計算コストや倫理的課題も存在し、技術革新と社会的責任のバランスが求められます。ニューラルネットワークは、私たちの生活を革新する一方で、未来の知能社会をどう形作るかを考える契機となるでしょう。
理解を深める資料
- Google:活性化関数 — 線形変換だけを重ねる場合との違い。
- Goodfellowほか:Generative Adversarial Networks — GANの原著論文。

